Python3 基本数据类型
Python 3 基本数据类型
本文中交替出现 Python 的编译模式和交互模式代码块,为便于区分,带有
>>>的 Python 代码块为交互模式,其余 Python 代码块为编译模式。
一、数字类型(Number)
1. 整型(int)
- 任意大小整数(Python 3 中
int没有范围限制)
1 | a = 42 |
2. 浮点型(float)
- 带小数点的数字,精度有限
1 | x = 3.1415 |
3. 复数型(complex)
- 用于科学计算,
j表示虚数单位
1 | z = 2 + 3j |
二、字符串类型(str)
由字符组成的文本,使用 ' 或 " 包围,属于可迭代对象。
1 | s = "Hello, Python!" |
Python 转义字符
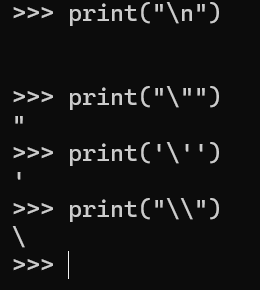
在需要在字符中使用特殊字符时,python 用反斜杠\转义字符。如下表:
| 转义字符 | 描述 |
|---|---|
| \ | 反斜杠符号 |
| ' | 单引号 |
| " | 双引号 |
| \n | 换行符 |
字符串格式化
建议使用 f-strings (Python 3.6+),这是最简洁和高效的方法,使用前缀 f 或 F,可以直接在字符串中嵌入变量。
1 | name = "Alice" |
字符串内建方法
tips:
- 如果需要详细了解每个方法,请访问点击链接进行跳转。
- 我对自认为比较重要的方法进行了加粗,请重点关注。请先掌握加粗的部分!
| 序号 | 方法及链接 | 含义 | 示例 |
|---|---|---|---|
| 1 | capitalize() | 将字符串的第一个字符转换为大写 | 'hello'.capitalize() → 'Hello' |
| 2 | center(width, fillchar) | 返回一个指定宽度居中的字符串,使用指定字符填充 | 'hi'.center(6, '*') → '**hi**' |
| 3 | count(str, beg=0, end=len(string)) | 返回子字符串在指定范围内出现的次数 | 'banana'.count('a') → 3 |
| 4 | bytes.decode(encoding=”utf-8”, errors=”strict”) | 解码 bytes 对象为字符串 | b'hello'.decode('utf-8') → 'hello' |
| 5 | encode(encoding=’UTF-8’) | 将字符串编码为指定格式的 bytes | '你好'.encode('utf-8') → b'\xe4\xbd\xa0\xe5\xa5\xbd' |
| 6 | endswith(suffix) | 检查是否以指定后缀结尾 | 'test.py'.endswith('.py') → True |
| 7 | expandtabs(tabsize=8) | 将制表符 (\t) 替换为空格 |
'a\tb'.expandtabs(4) → 'a b' |
| 8 | find(str) | 查找子串出现的最小索引,找不到返回 -1 | 'hello'.find('e') → 1 |
| 9 | index(str) | 类似 find(),但找不到会抛出异常 | 'hello'.index('e') → 1 |
| 10 | isalnum() | 判断是否只由字母和数字组成 | 'abc123'.isalnum() → True |
| 11 | isalpha() | 判断是否只由字母组成 | 'abc'.isalpha() → True |
| 12 | isdigit() | 判断是否只由数字组成 | '123'.isdigit() → True |
| 13 | islower() | 判断所有字母是否都是小写 | 'abc'.islower() → True |
| 14 | isnumeric() | 判断是否为纯数字字符 | '一二三'.isnumeric() → True |
| 15 | isspace() | 判断是否只包含空白符 | ' '.isspace() → True |
| 16 | istitle() | 判断字符串是否为标题格式 | 'This Is A Title'.istitle() → True |
| 17 | isupper() | 判断所有字母是否都是大写 | 'ABC'.isupper() → True |
| 18 | join(seq) | 使用指定分隔符连接序列元素 | '--'.join(['a', 'b', 'c']) → 'a--b--c' |
| 19 | len(string) | 获取字符串长度 | len('hello') → 5 |
| 20 | ljust(width, fillchar) | 左对齐填充到指定宽度 | 'hi'.ljust(5, '-') → 'hi---' |
| 21 | lower() | 转换为小写 | 'HELLO'.lower() → 'hello' |
| 22 | lstrip() | 删除左侧空格或指定字符 | ' hello'.lstrip() → 'hello' |
| 23 | maketrans() | 创建字符映射表用于 translate() | str.maketrans('ae', '12') |
| 24 | max(str) | 返回最大字符(按 ASCII 排序) | max('abc') → 'c' |
| 25 | min(str) | 返回最小字符 | min('abc') → 'a' |
| 26 | replace(old, new, max) | 替换子串,最多替换 max 次 | 'aabb'.replace('a', 'z', 1) → 'zabb' |
| 27 | rfind(str) | 从右侧查找子串 | 'hello'.rfind('l') → 3 |
| 28 | rindex(str) | 从右查找子串,找不到报异常 | 'hello'.rindex('l') → 3 |
| 29 | rjust(width, fillchar) | 右对齐填充 | 'hi'.rjust(5, '-') → '---hi' |
| 30 | rstrip() | 删除右侧空格 | 'hello '.rstrip() → 'hello' |
| 31 | split(str, num) | 按分隔符分割字符串 | 'a,b,c'.split(',') → ['a', 'b', 'c'] |
| 32 | splitlines(keepends) | 按行切分,可保留换行符 | 'a\nb'.splitlines() → ['a', 'b'] |
| 33 | startswith(str) | 判断是否以子串开头 | 'hello'.startswith('he') → True |
| 34 | strip(chars) | 删除两端空白 | ' hi '.strip() → 'hi' |
| 35 | swapcase() | 大小写互换 | 'AbC'.swapcase() → 'aBc' |
| 36 | title() | 转换为标题格式 | 'hello world'.title() → 'Hello World' |
| 37 | translate(table) | 按映射表转换字符串 | 'abc'.translate(str.maketrans('a', '1')) → '1bc' |
| 38 | upper() | 转换为大写 | 'hello'.upper() → 'HELLO' |
| 39 | zfill(width) | 前面填充 0,使字符串长度为 width | '7'.zfill(3) → '007' |
| 40 | isdecimal() | 检查是否为十进制数字 | '123'.isdecimal() → True |
字符串重点建方法
可迭代对象在后续的文章里面会讲解
str.join()
Python join() 方法用于将序列中的元素以指定的字符连接生成一个新的字符串。
1 | str.join(sequence) |
- sequence :可迭代对象,要连接的元素序列。可迭代对象的内容必须是字符串
- str : 字符串对象
示例1 无损数据压缩
数据压缩,要求返回字符串中的字母的数量。
输入
1 | hkahjgjkghksjf |
输出
1 | a1f1g2h3j3k3s1 |
1 | def compressString(S): |
输出
1 | d2a2b2c2d3 |
示例2 接受可迭代对象
使用元组作为可迭代对象
1 | symbol = "-"; |
使用列表作为可迭代对象
1 | lis = ["1","2","3"] |
使用迭代器(map对象) 作为可迭代对象
1 | lis = [1,2,3] |
使用生成器作为可迭代对象,生成器返回一个迭代器,本质上就是一个迭代器。
1 | gene = (str(i) for i in range(10)) |
str.split()
split() 方法通过指定分隔符对字符串进行切片,该方法将字符串分割成子字符串并返回一个由这些子字符串组成的列表。
如果第二个参数 num 有指定值,则分割为 num+1 个子字符串。
split()方法特别适用于根据特定的分隔符将字符串拆分成多个部分。
语法
1 | str.split(str="", num=string.count(str)). |
str分隔符,默认为所有的空字符,包括空格" "、换行"\n"、制表符"\t"等。num分割次数,如果设置了这个参数,则最多分割成maxsplit+1个子字符串。默认为-1, 即分隔所有。
返回值
返回分割后的字符串列表
示例
1 | str = "this is string example....\nwow!!!" |
三、布尔类型(bool)
- 只有两个值:
True和False - 实际上是
int的子类:True == 1,False == 0
1 | a = True |
四、序列类型(可迭代、可索引)
1. 列表(list)可变
属于可变数据类型
列表嵌套
使用嵌套列表即在列表里创建其它列表,例如:
1 | >>> a = ['a', 'b', 'c'] |
切片访问
扩展切片指的是这样的切片形式:
1 | a[start:stop:step] |
其中
step是一个非零整数此时切片的行为可概括为:从
start对应的位置出发,以step为步长索引序列,直至越过stop对应的位置(不包括stop)
需要详细解释的是step分别为正数和负数的两种情况。
step为正数
当step为正数时,切片行为很容易理解,start和stop的截断和缺省规则也与简单切片完全一致:
1 | a |
step为负数
当step为负数时,切片将其解释为从start出发以步长|step|逆序索引序列,此时,start和stop的截断依然遵循前述规则,但缺省发生一点变化,因为我们说过,在缺省的情况下,Python的行为是尽可能取最大区间,此时访问是逆序的,start应尽量取大,stop应尽量取小,才能保证区间最大,因此:
按照扩充索引范围的观点,
start的缺省值是无穷大(),stop的缺省值是无穷小()
1 | a |
Python 列表脚本操作符
列表对 + 和 * 的操作符与字符串相似。+ 号用于组合列表,* 号用于重复列表。
如下所示:
| Python 表达式 | 结果 | 描述 |
|---|---|---|
| len([1, 2, 3]) | 3 | 长度 |
| [1, 2, 3] + [4, 5, 6] | [1, 2, 3, 4, 5, 6] | 组合 |
| [‘Hi!’] * 4 | [‘Hi!’, ‘Hi!’, ‘Hi!’, ‘Hi!’] | 重复 |
| 3 in [1, 2, 3] | True | 元素是否存在于列表中 |
| for x in [1, 2, 3]: print(x, end=” “) | 1 2 3 | 迭代 |
Python 列表函数
tips:
- 如果需要详细了解每个方法,请访问点击链接进行跳转。
- 我对自认为比较重要的方法进行了加粗,请重点关注。请先掌握加粗的部分!
| 序号 | 函数 | 含义与小示例 |
|---|---|---|
| 1 | cmp(list1, list2) | 比较两个列表的元素是否相等。📌 示例:cmp([1, 2], [1, 2]) → 0(相等)⚠️ 仅适用于 Python 2,Python 3 中已移除。 |
| 2 | len(list) | 返回列表元素个数。📌 示例:len([1, 2, 3]) → 3 |
| 3 | max(list) | 返回列表中最大值。📌 示例:max([5, 9, 2]) → 9 |
| 4 | min(list) | 返回列表中最小值。📌 示例:min([5, 9, 2]) → 2 |
| 5 | list(seq) | 将其他序列(如元组)转换为列表。📌 示例:list((1, 2)) → [1, 2] |
Python 列表内置方法
| 序号 | 方法 | 含义与小示例 |
|---|---|---|
| 9 | list.sort(cmp=None, key=None, reverse=False) | 对列表原地排序,可指定规则。📌 示例:lst = [3, 1, 2]; lst.sort() → [1, 2, 3]💡 key=str.lower 可用于忽略大小写排序 |
| 1 | list.append(obj) | 在列表末尾添加一个元素。📌 示例:lst = [1]; lst.append(2) → [1, 2] |
| 2 | list.count(obj) | 返回某元素在列表中出现的次数。📌 示例:[1, 2, 2].count(2) → 2 |
| 3 | list.extend(seq) | 将序列中元素逐一添加到列表。📌 示例:[1].extend([2, 3]) → [1, 2, 3] |
| 4 | list.index(obj) | 返回某元素第一次出现的位置。📌 示例:[3, 4, 5].index(4) → 1 |
| 5 | list.insert(index, obj) | 在指定位置插入元素。📌 示例:lst = [1, 3]; lst.insert(1, 2) → [1, 2, 3] |
| 6 | list.pop([index=-1]) | 移除并返回指定索引的元素,默认是最后一个。📌 示例:[1, 2, 3].pop() → 返回 3,列表变为 [1, 2] |
| 7 | list.remove(obj) | 移除列表中某元素的第一个匹配项。📌 示例:[1, 2, 2].remove(2) → [1, 2] |
| 8 | list.reverse() | 将列表原地反转。📌 示例:lst = [1, 2, 3]; lst.reverse() → [3, 2, 1] |
较重要的列表内置方法
List sort()
描述
sort() 函数用于对原列表进行排序,如果指定参数,则使用比较函数指定的比较函数。
语法
sort()方法语法:
1 | list.sort( key=None, reverse=False) |
参数
- key – 主要是用来进行比较的元素,只有一个参数,具体的函数的参数就是取自于可迭代对象中,指定可迭代对象中的一个元素来进行排序。
- reverse – 排序规则,reverse = True 降序, reverse = False 升序(默认)。
返回值
该方法没有返回值,但是会对列表的对象进行排序。
综合示例
1 | # 获取列表的第二个元素 |
key也可以接受lambda匿名函数表达式,还是上一题,可以这样写,同样的效果。匿名函数接下来的文章会仔细讲。
1 | random2 = [[2, 2], [3, 4], [4, 1], [1, 3]] |
List index()
描述
index() 函数用于从列表中找出某个值第一个匹配项的索引位置。
语法
index()方法语法:
1 | list.index(x[, start[, end]]) |
参数
- x– 查找的对象。
- start– 可选,查找的起始位置。
- end– 可选,查找的结束位置。
返回值
该方法返回查找对象的索引位置,如果没有找到对象则抛出异常。
List insert()
描述
insert() 函数用于将指定对象插入列表的指定位置。
语法
insert()方法语法:
1 | list.insert(index, obj) |
参数
- index – 对象obj需要插入的索引位置。
- obj – 要插入列表中的对象。
返回值
该方法没有返回值,但会在列表指定位置插入对象。
示例
1 | a = ['Google', 'Runoob', 'Taobao'] |
List pop()
描述
pop() 函数用于移除列表中的一个元素(默认最后一个元素),并且返回该元素的值。
语法
pop()方法语法:
1 | list.pop([index=-1]) |
参数
- index – 可选参数,要移除列表元素的索引值,不能超过列表总长度,默认为 index=-1,删除最后一个列表值。
返回值
该方法返回从列表中移除的元素对象。
示例
1 | a = ['Google', 'Runoob', 'Taobao'] |
List remove()
描述
remove() 函数用于移除列表中某个值的第一个匹配项。
语法
remove()方法语法:
1 | list.remove(obj) |
参数
- obj – 列表中要移除的对象。
返回值
该方法没有返回值但是会移除列表中的某个值的第一个匹配项。
示例
1 | a = [1,2,3,4] |
2. 元组(tuple)不可变
Python 中的元组(tuple)是一种内置的数据结构,用于存储一组有序的元素。元组与列表类似,但它们的一个重要区别是元组是不可变的,即一旦创建,元组的元素就不能修改、添加或删除。这使得元组可以用作键或存储在集合等需要不可变类型的地方。
创建元组
使用 tuple() 函数创建元组
可以使用内置的 tuple() 函数将其他可迭代对象(如列表、字符串等)转换为元组:
1 | list_to_tuple = tuple([1, 2, 3]) |
使用生成器表达式创建元组
可以通过生成器表达式创建元组,但需要显式地使用 tuple() 函数,因为生成器表达式本身创建的是生成器对象:
1 | generator_tuple = tuple(x for x in range(5)) |
示例代码汇总
以下是一个完整的示例代码,展示了不同创建元组的方式:
1 | # 创建空元组 |
元组的方法
count() 方法
count() 方法用于统计指定元素在元组中出现的次数。
语法:
1 | python |
参数:
element:需要统计出现次数的元素。
返回值
- 指定元素在元组中出现的次数。
示例
1 | my_tuple = (1, 2, 2, 3, 4, 2, 5) |
index()方法
index() 方法用于查找指定元素在元组中的第一次出现的位置(索引)。如果元素不存在,会抛出 ValueError。
语法:
1 | tuple.index(element, start=0, end=len(tuple)) |
参数:
element:需要查找的元素。start(可选):搜索的起始位置,默认为0。end(可选):搜索的结束位置,默认为元组的长度。
返回值:
- 指定元素在元组中第一次出现的位置。
示例:
1 | my_tuple = (1, 2, 3, 4, 5) |
元组的切片
元组支持切片操作来访问其子集:
1 | my_tuple = (10, 20, 30, 40, 50) |
元组的嵌套
元组可以包含其他元组(或列表、字典等),形成嵌套结构:
1 | nested_tuple = ((1, 2, 3), (4, 5, 6), (7, 8, 9)) |
元组的解包
元组的解包(Tuple Unpacking)是Python中的一种语法特性,允许将元组中的元素直接赋值给多个变量。解包可以提高代码的可读性和简洁性,特别是在函数返回多个值的情况下。以下是关于元组解包的详细解释和示例。
基本解包
当元组的元素数量与变量数量一致时,可以直接解包元组:
1 | my_tuple = (1, 2, 3) |
使用 * 运算符解包
当变量数量不确定时,可以使用 * 运算符来捕获剩余的元素。* 前缀表示该变量将接收一个列表,包含元组中所有未分配的元素:
1 | my_tuple = (1, 2, 3, 4, 5) |
你也可以将 * 运算符用于中间位置:
1 | my_tuple = (1, 2, 3, 4, 5) |
嵌套解包
当元组中包含嵌套元组时,可以进行嵌套解包:
1 | my_tuple = (1, (2, 3), 4) |
在函数返回值中的解包
函数返回多个值时,可以直接解包这些值:
1 | def get_coordinates(): |
元组的遍历
在Python中,元组的遍历(iteration)非常简单,可以使用多种方法来遍历元组中的元素。以下是几种常见的遍历元组的方法及示例代码。
使用 for 循环遍历元组
最常见的方法是使用 for 循环直接遍历元组中的元素:
1 | my_tuple = (1, 2, 3, 4, 5) |
输出:
1 | 2 |
使用 enumerate() 函数
enumerate() 函数在遍历元组时,同时获取元素的索引和值:
1 | my_tuple = (1, 2, 3, 4, 5) |
输出:
1 | Index: 0, Element: 1 |
使用列表推导式
虽然列表推导式通常用于生成列表,但也可以用于遍历元组并执行操作:
1 | my_tuple = (1, 2, 3, 4, 5) |
输出:
1 | 1 |
遍历包含嵌套元组的元组
如果元组中包含嵌套元组,可以使用递归的方法遍历所有元素:
1 | # 递归打印 |
同理,如果想要打印嵌套的列表,只需要把if isinstance(element,tuple):换成if isinstance(element,list):即可。
输出:
1 | 1 |
元组的不可变性
在Python中,字典是一种键值对的集合,键用于标识对应的值。为了保证字典的性能和正确性,字典的键必须是不可变的,这意味着键的哈希值在整个生命周期中不能改变。下面是对这个概念的详细解释。
哈希值与不可变性
- 哈希值(Hash):哈希值是通过哈希函数对对象进行运算后得到的一个整数值。这个值用于在哈希表(如字典)中快速查找键对应的值。
- 不可变性:为了确保哈希值不变,键必须是不可变对象。不可变对象在创建后其状态不能被修改,包括其值和哈希值。
为什么字典的键必须是不可变的
- 哈希表工作原理:
- 字典内部使用哈希表实现。哈希表使用哈希值来快速定位存储数据的位置。
- 当我们使用键查找值时,Python会对键调用哈希函数,得到哈希值,并根据这个值快速找到对应的存储位置。
- 哈希值不变的重要性:
- 如果字典键的哈希值改变,哈希表将无法正确定位该键的位置,导致查找、插入和删除操作的错误。
- 为了保持哈希值的稳定性,字典键必须是不可变对象(例如元组、字符串、数字)。
不可变对象的例子
以下是一些不可变对象的例子,它们可以作为字典的键:
- 数字(如整数、浮点数)
- 字符串
- 元组(包含不可变对象的元组)
可变对象的例子
可变对象在创建后可以改变其状态,因此不能作为字典的键:
- 列表
- 字典
- 集合
示例
使用不可变对象作为字典键
1 | # 使用整数作为键 |
尝试使用可变对象作为字典键
1 | # 尝试使用列表作为键会抛出TypeError |
输出:
1 | 错误: unhashable type: 'list' |
3. 字符串(str)是不可变序列(见上)
4. range(range(start, stop[, step]))
1 | r = range(1, 5) |
五、集合类型(set、frozenset)
1. 集合(set):无序、唯一元素,可变
1 | s = {1, 2, 3} |
什么是 set(集合)?
在 Python 中,集合(set)是一种无序、不可重复的元素集合。
1 | # 创建一个集合 |
特性总结:
- ✅ 元素唯一,不允许重复。
- ❌ 无序,不能通过索引访问。
- 🔁 支持集合运算(交集、并集、差集等)。
- 📌 可变(可以添加、删除元素)。
创建集合
1 | # 使用花括号 |
注意:空集合要用 set(),不能用 {},后者是空字典。
集合运算
1 | A = {1, 2, 3, 4} |
| 操作 | 语法 | 示例 |
|---|---|---|
| 并集 | `A | B或A.union(B)` |
| 交集 | A & B 或 A.intersection(B) |
{3, 4} |
| 差集 | A - B 或 A.difference(B) |
{1, 2} |
| 对称差集 | A ^ B 或 A.symmetric_difference(B) |
{1, 2, 5, 6} |
判断子集/超集/相交
1 | A.issubset(B) # A 是否是 B 的子集 |
集合不能包含可变元素(如列表、字典)
1 | s = set() |
常用方法与操作
| 方法 | 含义与示例 |
|---|---|
| add() | 向集合中添加一个元素。s = {1, 2}; s.add(3); print(s) # {1, 2, 3} |
| clear() | 清空集合中所有元素。s = {1, 2}; s.clear(); print(s) # set() |
| copy() | 返回集合的浅拷贝。s1 = {1, 2}; s2 = s1.copy(); print(s2) # {1, 2} |
| difference() | 返回当前集合与其他集合的差集。s1 = {1, 2, 3}; s2 = {2, 3}; print(s1.difference(s2)) # {1} |
| difference_update() | 从当前集合中移除同时在指定集合出现的元素。s1 = {1, 2, 3}; s1.difference_update({2}); print(s1) # {1, 3} |
| discard() | 删除指定元素,如果不存在不报错。s = {1, 2}; s.discard(2); print(s) # {1} |
| intersection() | 返回两个集合的交集。s1 = {1, 2}; s2 = {2, 3}; print(s1.intersection(s2)) # {2} |
| intersection_update() | 保留集合中与指定集合交集的部分。s1 = {1, 2, 3}; s1.intersection_update({2, 3, 4}); print(s1) # {2, 3} |
| isdisjoint() | 判断两个集合是否没有交集。{1, 2}.isdisjoint({3, 4}) # True |
| issubset() | 判断当前集合是否为指定集合的子集。{1, 2}.issubset({1, 2, 3}) # True |
| issuperset() | 判断当前集合是否为指定集合的超集。{1, 2, 3}.issuperset({1, 2}) # True |
| pop() | 随机删除并返回一个元素。s = {1, 2, 3}; s.pop() # 返回某个元素,并将其移除 |
| remove() | 移除指定元素,若不存在则抛出异常。s = {1, 2}; s.remove(1); print(s) # {2} |
| symmetric_difference() | 返回两个集合的对称差集(不重复部分。{1, 2, 3}.symmetric_difference({3, 4}) # {1, 2, 4} |
| symmetric_difference_update() | 用两个集合的对称差集更新当前集合。s = {1, 2, 3}; s.symmetric_difference_update({2, 4}); print(s) # {1, 3, 4} |
| union() | 返回两个集合的并集。{1, 2}.union({2, 3}) # {1, 2, 3} |
| update() | 向集合添加多个元素。s = {1}; s.update([2, 3]); print(s) # {1, 2, 3} |
| len() | 返回集合中元素的个数。len({1, 2, 3}) # 3 |
示例
去除字符串中重复字符:
1
2s = "helloooworld"
print(set(s)) # {'e', 'd', 'h', 'o', 'l', 'r', 'w'}两个列表的交集:
1
2
3
a = [1, 2, 3, 4]
b = [3, 4, 5, 6]
print(set(a) & set(b)) # {3, 4}示例:去除重复元素
1
2
3nums = [1, 2, 2, 3, 4, 4, 5]
unique = set(nums)
print(unique) # 输出: {1, 2, 3, 4, 5}
2. 冻结集合(frozenset):不可变集合
1 | fs = frozenset([1, 2, 3]) |
集合支持交并差等集合操作:
1 | a = {1, 2, 3} |
六、映射类型:字典(dict)
数据结构
| 数据类型 | 内容 |
|---|---|
| 可变数据类型 | List(列表)、Dictionary(字典)、Set(集合) |
| 不可变数据类型 | Number(数字)、String(字符串)、Tuple(元组) |
字典是一种可变数据类型,是通过哈希表实现的,所以具有以下性质
字典的键:
- 不可变性:索引,必须为不可变数据类型(哈希值不变)。可以用数字,字符串或元组充当,而用列表就不行.
- 唯一性:不允许同一个键出现两次
- 实时性:创建时如果同一个键被赋值两次,后一个值会被记住
字典的值:可以为任意数据类型
格式如下所示:
1 | d = {key1 : value1, key2 : value2, key3 : value3 } |
键值对结构(key-value)
1 | d = {'name': 'Alice', 'age': 20} |
创建字典
- 直接创建
dic = {}
- 内建函数
dict()创建
emptydic = dict()
内置函数
| 内置函数 | 作用 | 实例 |
|---|---|---|
len(dict) |
计算字典元素个数,即键的总数。 | >>> tinydict = {‘Name’: ‘Runoob’, ‘Age’: 7, ‘Class’: ‘First’} >>> len(tinydict) 3 |
str(dict) |
输出字典,可以打印的字符串表示。 | >>> tinydict = {‘Name’: ‘Runoob’, ‘Age’: 7, ‘Class’: ‘First’} >>> str(tinydict) “{‘Name’: ‘Runoob’, ‘Class’: ‘First’, ‘Age’: 7}” |
内置方法
tips:
- 如果需要详细了解每个方法,请访问点击链接进行跳转。
- 我对自认为比较重要的方法进行了加粗,请重点关注。请先掌握加粗的部分!
| 方法 | 描述 | 返回值 |
|---|---|---|
key in dict |
如果键在字典dict里返回true,否则返回false | bool |
dict.update(dict2) |
把字典dict2的键/值对更新到dict里 | |
dict.get(key, default=None) |
返回指定键的值,如果键不在字典中返回 default 设置的默认值 | 指定键的值 |
dict.setdefault(key, default=None) |
和get()类似, 但如果键不存在于字典中,将会添加键并将值设为default | |
dict.fromkeys(seq[, value]) |
创建一个新字典,以序列seq中元素做字典的键,val为字典所有键对应的初始值 | dic |
dic.clear() |
删除字典内所有元素 | 无 |
dict.copy() |
返回一个字典的深浅复制 | dic |
dict.items() |
以列表返回一个视图对象 | list |
dict.keys() |
返回一个视图对象(可迭代对象) | 可迭代对象 |
dict.values() |
返回一个视图对象(可迭代对象) | 可迭代对象 |
| pop(key,default]) | 删除字典 key(键)所对应的值,返回被删除的值。 | 被删除的值 |
popitem() |
返回并删除字典中的最后一对键和值。 |
示例
数据压缩,要求返回字符串中的字母的数量并按照a-z排序。
输入
1 | hkahjgjkghksjf |
输出
1 | a1f1g2h3j3k3s1 |
1 | def count_sort(S) : |
输出
1 | {'d': 5, 'c': 2, 'a': 2, 'b': 2} |
七、None 类型(空值)
- 表示“没有值”的特殊对象
1 | a = None |
八、类型转换(常用转换函数)
1 | int("42") # 转换为整数 42 |
类型判断与检查
1 | x = 42 |
总结表格:
| 类型名称 | 类名 | 是否可变 | 示例 |
|---|---|---|---|
| 整数 | int |
❌ | 42 |
| 浮点数 | float |
❌ | 3.14 |
| 复数 | complex |
❌ | 2 + 3j |
| 布尔值 | bool |
❌ | True, False |
| 字符串 | str |
❌ | "hello" |
| 列表 | list |
✅ | [1, 2, 3] |
| 元组 | tuple |
❌ | (1, 2, 3) |
| 集合 | set |
✅ | {1, 2, 3} |
| 冻结集合 | frozenset |
❌ | frozenset([1, 2, 3]) |
| 字典 | dict |
✅ | {'a': 1, 'b': 2} |
| None 类型 | NoneType |
❌ | None |